| Планируемые результаты обучения (Знать, Уметь, Владеть)
|
Цель курса – формирование у студентов магистерской программы "Информатика и английский язык" системных знаний и практических навыков в области современных методов информационного анализа текстовых данных с использованием открытых программных решений.
- Задачи курса
- Освоение теоретических основ и методологии информационного анализа текста в, включая понимание принципов обработки естественного языка, статистического анализа текстовых корпусов.
- Развитие практических навыков работы с открытыми программными инструментами, особенно средой R и специализированными пакетами для текстовой аналитики (tidytext, quanteda, tm), а также освоение техник получения текстовых данных через MediaWiki API и другие открытые источники.
- Формирование компетенций интеграции количественных и качественных методов анализа для решения исследовательских.
В результате изучения дисциплины студент должен:
- знать
- Теоретические основы информационного анализа текста
- Современные методы обработки естественного языка и компьютерной лингвистики
- Принципы работы с MediaWiki API и другими источниками текстовых данных
- Основы статистической обработки текстовых корпусов в среде R
- уметь
- Проводить предобработку и нормализацию текстовых данных (токенизация, стемминг, лемматизация)
- Использовать пакеты R для текстовой аналитики (tidytext, quanteda, tm, stringr)
- Получать и обрабатывать текстовые данные через MediaWiki API
- Применять методы анализа тональности и настроений в текстах
- Проводить психолингвистический анализ текстовых данных
- Визуализировать результаты анализа текста (облака слов, графики частотности, сети).
- владеть
- Навыками программирования в среде R для решения задач текстовой аналитики
- Методиками интегрированного анализа больших текстовых корпусов
- Инструментами веб-аналитики текста и онлайн-сервисами
|
| Содержание разделов курса
|
-
- Теоретические основы информационного анализа текста
- Введение в психолингвистические основы анализа текста.
- Современные подходы к компьютерной обработке естественного языка.
- Связь между лингвистикой и информационным анализом текста.
- Основные направления текстовой аналитики: анализ тональности, тематическое моделирование, анализ стиля. : :Этические аспекты анализа текстовых данных.
- Сравнительный анализ различных подходов к обработке текста
- Работа с примерами психолингвистического анализа
- Обзор современных исследований в области текстовой аналитики
- Основы работы в среде R для анализа текста
- Установка и настройка среды R и RStudio. Основы синтаксиса R и принципы tidy data.
- Введение в экосистему tidyverse для анализа данных.
- Специализированные пакеты для работы с текстом: установка и первое знакомство с tidytext, quanteda, tm.
- Основные структуры данных для хранения текста в R.
- Импорт и экспорт текстовых данных различных форматов.
- Предобработка и подготовка текстовых данных
- Этапы предобработки текстовых данных. Токенизация: разбиение текста на слова, предложения, n-граммы. : Нормализация текста: приведение к нижнему регистру, удаление пунктуации и специальных символов.
- Работа со стоп-словами для русского и английского языков. Стемминг и лемматизация: принципы и инструменты. Создание корпусов и документно-терминных матриц. Обработка больших текстовых массивов.
- Получение текстовых данных через MediaWiki API
- Введение в MediaWiki API: структура, возможности, ограничения. Основные методы получения содержимого страниц. Работа с различными форматами данных: wikitext, HTML, plain text. Использование пакетов httr и jsonlite для HTTP-запросов в R. Создание функций для автоматического извлечения текстов из Wikipedia. Обработка метаданных и структурированной информации.
- Статистический анализ и визуализация текстовых данных
Частотный анализ слов и n-грамм. Статистические метрики в анализе текста: TF-IDF, взаимная информация, коэффициенты ассоциации. Анализ коллокаций и совместной встречаемости слов. Методы визуализации текстовых данных: облака слов, графики частотности, тепловые карты. Сетевой анализ текстов и построение графов слов. Сравнительный анализ текстовых корпусов. Статистические тесты для текстовых данных
|
| Видео запись
|
|
| Среды и средства, которые поддерживают учебный курс
|
R, OpenRefine, VOYANT Tools, MediaWiki, MediaWiki API
|
| Книги, на которых основывается учебный курс
|
APIs for social scientists: A collaborative review, Text Mining with R: A Tidy Approach
|
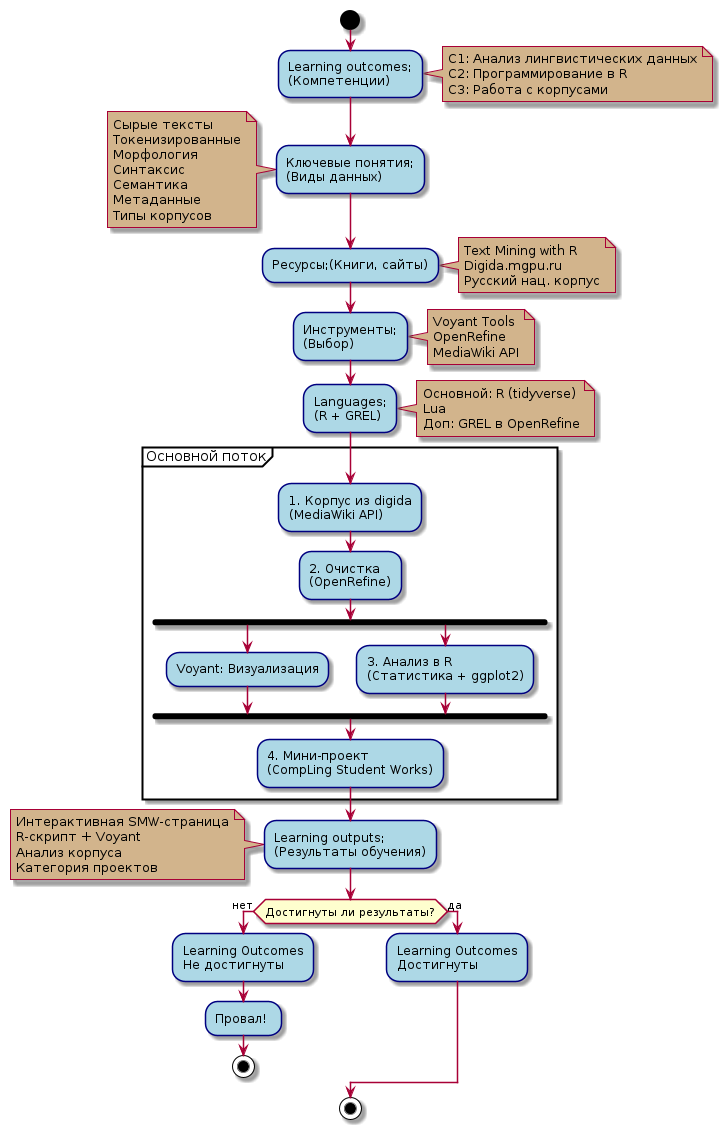
Пояснения к диаграмме
Вы уже хорошо знаете digida.mgpu.ru и умеете встраивать туда Voyant Tools, поэтому мы сразу погрузимся в практический workflow курса "Программирование и лингвистические данные". Навыки, которые вы здесь освоите — работа с MediaWiki API, очистка в OpenRefine, анализ в R — универсальны и применимы к любым открытым MediaWiki-площадкам, от ScratchWiki и образовательных вики до вики научных сообществ. Digida мы понимаем лучше всего, но инструменты курса работают на всем образовательном поле интернета!
Начнем с разбора типов лингвистических данных на живых примерах digida: сырые тексты статьи "R (язык программирования)", токенизированные слова из категории "Категория:Язык программирования", морфологические формы в SMW-свойствах, семантические метки вроде "Лингвистика" в Field of knowledge. Вспомните VOYANT Tools — встроите апплет в тестовую страницу digida и увидите облако слов из категории "Понятие" или тренды частот ScratchWiki-статей о блочных языках.
Процесс, который потом примените где угодно. Сначала выкачаете корпус через MediaWiki API: составите запрос на 50–100 страниц из категории digida ("Язык программирования") или ScratchWiki ("Educational Programming"), получите JSON/CSV и загрузите в Voyant для первого обзора. Потом откроете данные в OpenRefine: фасеты, кластеризация, GREL-формулы — уберете дубликаты, нормализуете регистр, получите чистый CSV с колонками "текст", "категория", "дата".
R - основа курса. Напишете скрипты на tidyverse + tidytext: чтение CSV, токенизация, частоты слов/n-грамм, стоп-слова, группировка по мета